Serveur MCP axé sur la gouvernance qui contrôle l'accès de l'IA aux données sensibles
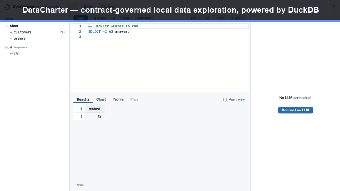
datacharter par Datacharter est un serveur de Protocole de Contexte Modèle gouverné qui restreint l'accès des agents IA aux données locales et distantes. L'outil offre aux agents un espace de travail de style SQL afin qu'ils puissent exécuter des requêtes contre des sources fédérées tout en limitant l'exposition externe. Il met l'accent sur les mesures de protection de la vie privée, l'audit des requêtes et l'exécution en lecture seule pour réduire le risque opérationnel. Destiné aux ingénieurs de données, aux équipes de sécurité et aux développeurs qui ont besoin d'interactions IA auditées et conformes aux politiques avec des ensembles de données de production et locaux.
Quelles tâches pouvez-vous réellement utiliser pour cela ?
Le serveur permet aux modèles de langage d'agir en tant qu'assistants de données capables de requêtes dans un environnement contrôlé, permettant des requêtes analytiques, des visualisations de base et un profilage de jeux de données. Le profilage de données intégré et la légende des graphiques transforment les résultats des requêtes en résumés lisibles par des humains. Les cas d'utilisation incluent l'analyse exploratoire de données locales et d'entreprise mixtes et la génération de réponses soutenues par SQL à partir de sources jointes, l'outil produisant des résultats de requêtes plutôt que des enregistrements bruts non restreints.
Quelle est la confidentialité et l'auditabilité des résultats de l'outil ?
Des contrôles de confidentialité sont appliqués automatiquement au moment de la requête, avec un masquage automatique des PII et une suppression de k-anonymité déclarée comme partie de la conception. Le système enregistre l'activité des agents à l'aide d'un journal d'audit à preuve de falsification et enchaîné par hachage, produisant un paquet de preuves vérifiables pour chaque requête. Des fils de canari peuvent être configurés pour signaler les tentatives d'exfiltration de données accidentelles, donnant aux équipes de sécurité des alertes traçables liées à des requêtes d'agents spécifiques.
Quelles entrées et intégrations accepte-t-il ?
Le serveur fédère des données via DuckDB et accepte des formats de fichiers locaux tels que CSV, Parquet, JSON, Excel et SQLite, ainsi que des connexions à des entrepôts distants incluant Postgres, MySQL, SQL Server, Snowflake, BigQuery, Iceberg et Delta Lake. Les chemins d'installation incluent des paquets Python (pip/uvx) et Homebrew, et une version de bureau autonome existe en bêta. Il expose une interface de serveur MCP pour que les hôtes compatibles puissent l'appeler.
Est-il pratique de déployer et de l'intégrer dans des flux de travail existants ?
La gestion des données est conçue pour être locale en premier : le serveur se lie par défaut et ne rapporte aucune télémétrie, ce qui aide à garder les requêtes sur site. L'exécution est en lecture seule par construction, empêchant les écritures accidentelles dans les sources de données. Le développeur fournit un flux de travail de commande (par exemple, en utilisant uvx pour initialiser un espace de travail) et des intégrations avec des clients compatibles MCP afin que les équipes puissent ajouter le serveur dans les chaînes d'outils des agents sans changer les bases de données de production.
Le mieux adapté aux équipes qui nécessitent des requêtes d'agents auditées et basées sur des politiques
L'outil est un choix pratique pour les équipes soucieuses de la sécurité qui ont besoin d'un accès aux agents contraint par des politiques applicables ; sa conception locale et ses packs de preuves aident à atteindre les objectifs de conformité. Prévoyez une phase de configuration, car des garanties significatives dépendent de contrats soigneusement rédigés et de règles canari dans charter.yaml. Attendez-vous à maintenir un examen humain dans le processus pour des décisions à enjeux élevés motivées par l'analyse générée par les agents.